Ai Agent

AI Agent(也称人工智能代理)是一种能够感知环境、进行决策和执行动作的智能实体。
一个基于大模型的 AI Agent 系统可以拆分为大模型、规划、记忆与工具使用四个组件部分
常见推理模式
CoT(Chain of Thoughts 思维链)
用了思维链后,大模型把任务做了拆分并展示了每一步思考的过程
ReAct(Reason+Act)
包含 Reason 与 Act 两个部分,其中 Reason 就是大模型推理的过程,其推理运用了 CoT 的思想;Act 是与外界环境交互的动作。
Reflection && Reflexion

两个大模型的协作过程为:
- Generate 大模型收到用户的请求后,生成初始 response,并交给 Reflect 大模型。
- Reflect 会给出评估后,将评语等反馈返给 Generate 大模型。
- Generate 大模型根据评估做调整后,重新生成 response。
- 反复循环,直到达到用户设定的循环次数后,将最终的 response 返给用户
ReWOO(Reason WithOut Observation 无观察推理)
通过一次性规划所有步骤,减少多轮对话的成本和 token 消耗。
ai gent 项目
- https://github.com/microsoft/autogen 微软推出的 Agent 编程框架
- https://github.com/Significant-Gravitas/AutoGPT
Agent Memory:智能体运行时记忆(动态)
传统软件很少纠结“会不会忘”。进程崩了有数据库兜底,请求断了有 session 和 checkpoint,服务重启之后照着状态恢复就行。
为什么需要 Agent Memory
- LLM 原生上下文窗口有限,长对话、多轮交互、跨会话任务易丢失信息;LLM Memory:模型预训练知识(静态)
- Memory 让 Agent 实现知识累积、迭代推理、持续进化,支撑复杂长程任务;
- 区别于 RAG:Memory 聚焦交互态、会话内 / 跨会话动态信息,RAG 聚焦外部知识库
Agent 的记忆其实需要解决三个传统软件用不同机制分别处理过的问题。
- 第一是状态持久化。Agent 被打断之后,要记得自己刚才在干什么。这对应传统软件里的数据库状态、session 和 checkpoint。
- 第二是知识检索。Agent 要访问的信息,远超上下文窗口能装下的量,所以要有地方存,也要有办法取。这对应数据库、搜索索引和文档系统。
- 第三是经验累积。Agent 应该从过去的执行里学到东西,下次少踩坑。这一点,传统软件里没有完全等价的机制。最接近的是测试套件和事故复盘:它们都在把过去踩过的坑固化下来,让系统以后不要重犯
记忆模式组
四种模式:分层保留(Hierarchical Retention)、检索增强(RAG)、进度追踪(Progress Tracking)、失败日记(Failure Journals)
- 工作记忆 working memory,主要由分层保留来管理。
- 语义记忆 semantic memory,主要由 RAG 和其他检索机制来取回。
- 情节记忆 episodic memory,主要由进度追踪来沉淀。
- 失败记忆 failure memory,可以看作 episodic memory 里最值得主动召回的一类,由失败日记来管理。
- 程序性记忆 procedural memory,程序性记忆”把会做的活儿固化成可复用流程,也就是技能包(Skill Package)模式,是经验沉淀的高级形态。
基准测试算法
github.com/snap-research/locomo
Long-Context Conversations with Memory
它评估 AI 系统在长篇自然对话中回忆和推理信息的能力。LoCoMo 中的对话跨越数百个回合,模拟用户和 AI 助手之间的真实多会话交互
github.com/xiaowu0162/longmemeval
LongMemEval 是一个面向多轮多会话历史的长期记忆能力的评测基准
第三方实现
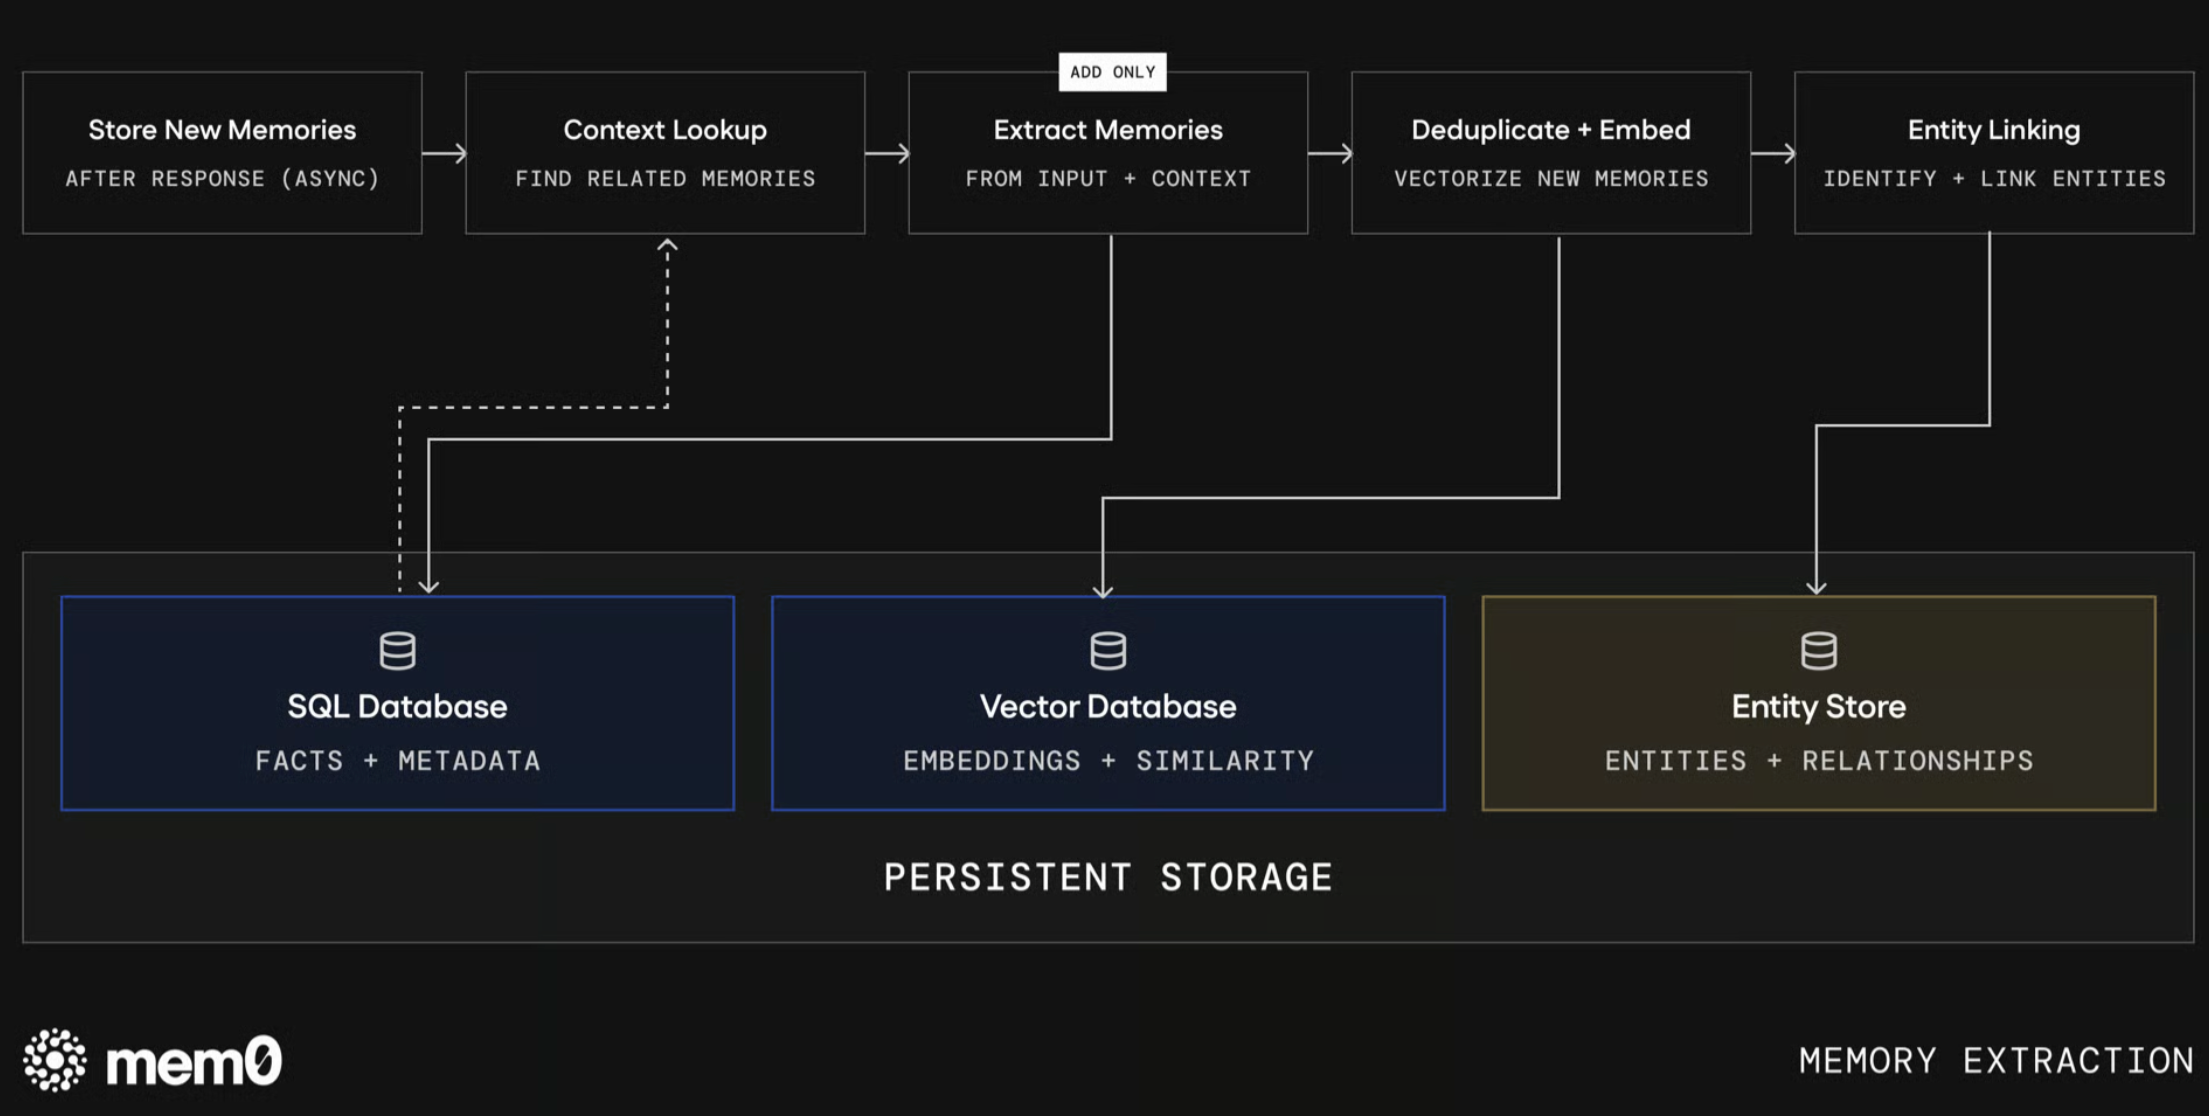
- https://github.com/mem0ai/mem0: Mem0是轻量级语义检索记忆框架,同时提供托管服务与开源版本,Pro版额外集成知识图谱能力。
- https://github.com/TencentCloud/TencentDB-Agent-Memory
- https://github.com/rohitg00/agentmemory: Agent 执行工具调用时,它通过 Hook 机制自动静默捕获所有操作
- https://github.com/vectorize-io/hindsight: 模仿人类记忆的组织方式:把原始事实、亲身经历、归纳观察、策划摘要分层管理,让 Agent 能像人一样从经验中形成理解,而不只是背诵对话记录。
- https://github.com/letta-ai/letta : 前身 formerly known as (f.k.a. ) MemGPT
- https://github.com/volcengine/OpenViking: 把上下文管理做成一个数据库,用文件系统的范式来组织所有内容。记忆、资源、技能,统一挂在 viking:// 这棵虚拟目录树下。
Mem0 (“mem-zero”)
原理: https://docs.mem0.ai/core-concepts/how-it-works
hindsight
架构: https://hindsight.vectorize.io/#architecture-deep-dive
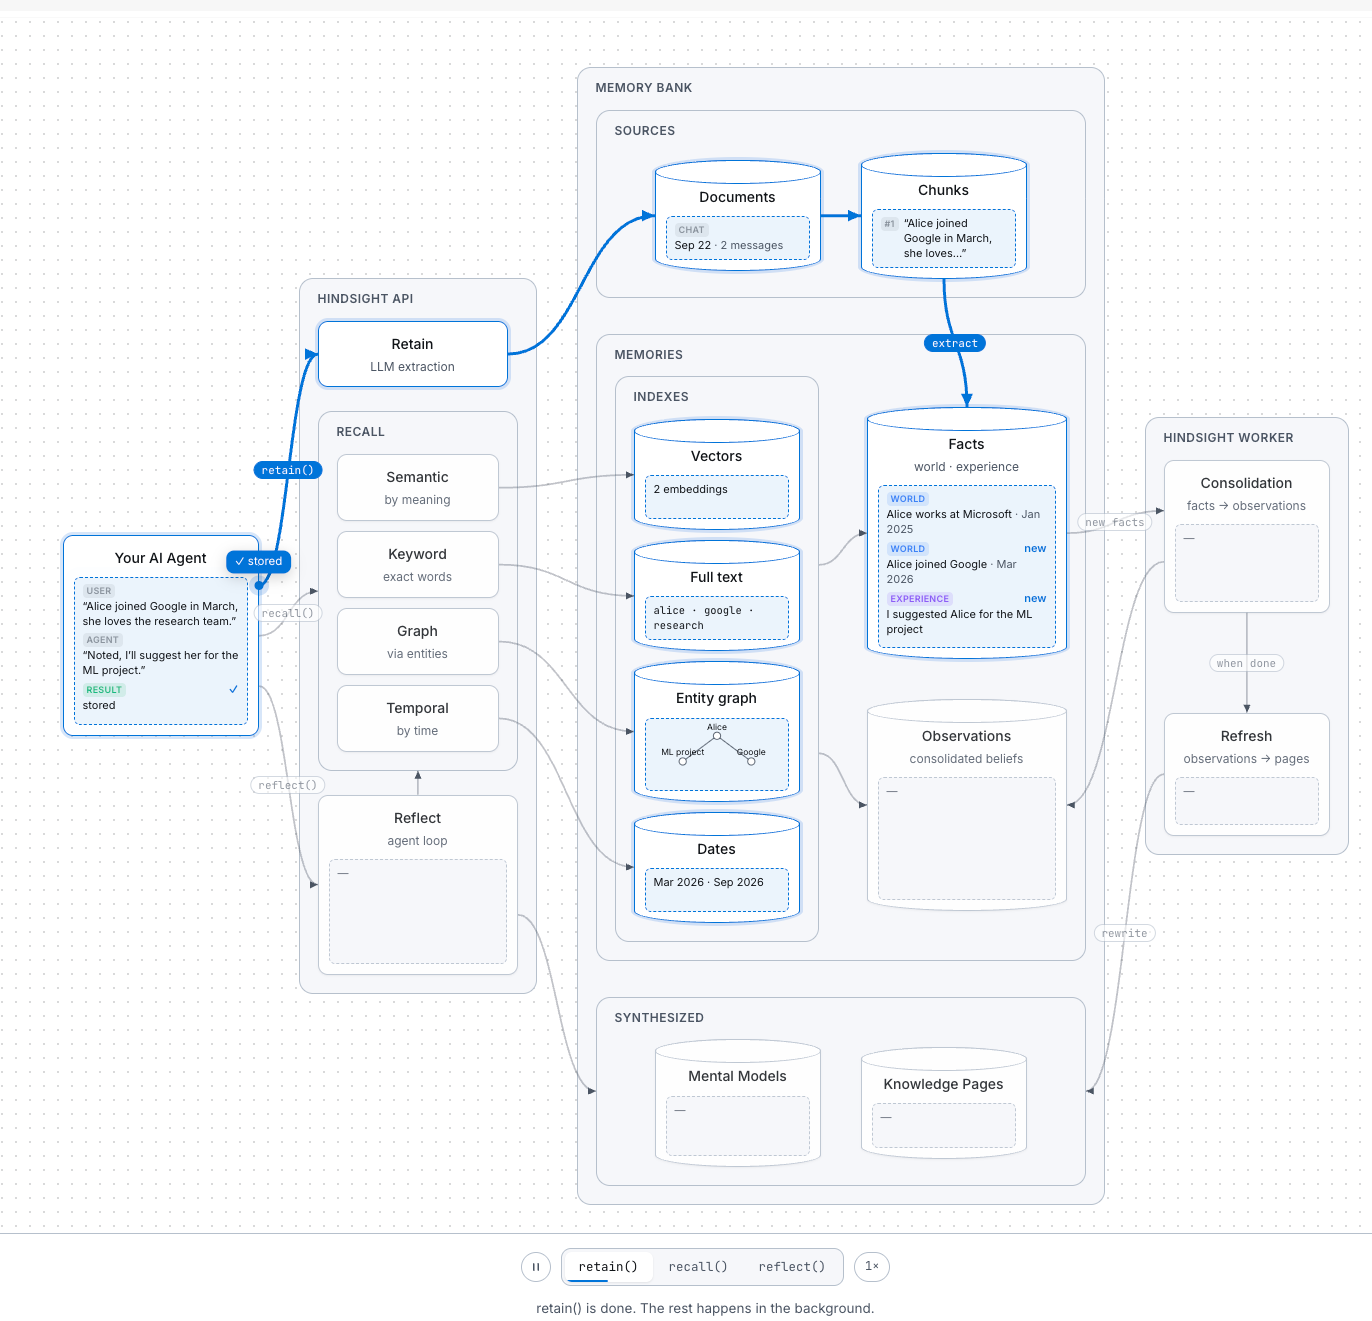
记忆组织为五种类型: https://hindsight.vectorize.io/#memory-types
- World fact — 关于外部世界的客观信息。 “Alice works at Google.”
- Experience fact — Agent 自身参与的对话和事件。 “I recommended Python to Bob.”
- Observation — 系统从多条原始事实中自动归纳出的模式和理解。. “User was a React enthusiast, has now switched to Vue.”
- Mental model — 用户策划的、针对常见查询的高层摘要。
- Knowledge page — a living document the bank writes about itself.
三个核心动作
retain: 结构化理解保留
Retain操作是Hindsight记忆系统的入口,负责将新信息转化为结构化的记忆存储。它不仅仅是简单的数据保存,还包括事实提取、实体识别、关系映射和时间标记等复杂处理过程.
Recall:四路并行检索 + 融合排序
recall() 负责从记忆库中检索信息。它不是单一策略检索,而是四种检索策略并行执行,然后融合结果:
| 策略 | 作用 | 适用场景 |
|---|---|---|
| Semantic | 向量相似度 | 意思相近但不完全匹配 |
| Keyword | BM25 精确匹配 | 特定术语、人名、版本号 |
| Graph | 实体、时间、因果关联 | 跨实体推理 |
| Temporal | 时间范围过滤 | “上周”“上个月”这类查询 |
Reflect:从记忆中生成新认知
reflect 是 Hindsight 中最像"思考"的操作。它不是检索已有信息,而是对已有记忆进行深度分析,形成新的连接和洞察。
