RAG 检索增强生成
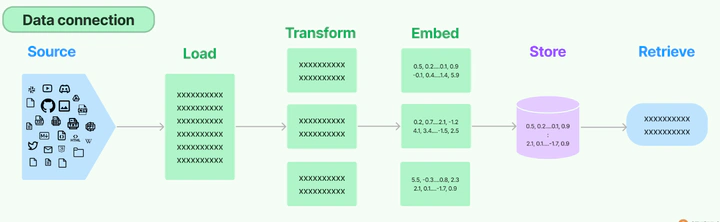
Retrieval-Augmented Generation,即检索增强生成,它结合了检索和生成的能力,为文本序列生成任务引入外部知识。
RAG 将传统的语言生成模型与大规模的外部知识库相结合,使模型在生成响应或文本时可以动态地从这些知识库中检索相关信息。
背景
向量搜索对比关键词搜索
关键词搜索(SQL 的 LIKE 查询)只能匹配字面。用户问“东西坏了怎么办”,文档里写的是“产品质量问题处理流程”,关键词一个都不重叠,但语义是同一件事
对比传统搜索引擎
传统搜索引擎和 RAG 技术在架构上确实有一些相似之处,都采用了两阶段的处理模式。
传统搜索引擎通常分为召回(Recall)和排序(Ranking)两个阶段:
- 召回阶段:通过倒排索引、term matching 等快速匹配文档,从海量库中筛选出与查询相关的候选文档集合。这一阶段侧重速度和覆盖度。
- 排序阶段:采用更精细的算法和更多特征,对召回的候选集进行精排,生成最终的排序结果。这一阶段侧重质量和相关性。
RAG 作为一种检索增强的生成式模型,也分为检索(Retrieval)和生成(Generation)两个阶段:
- 检索阶段:通过 embedding 向量相似度匹配等方式,从支撑知识库中检索出与输入最相关的 top-k 个知识片段。RAG 的检索通常是针对 passage 或 chunk 级别,相比传统搜索引擎粒度更细。
- 生成阶段:以输入 query 和检索出的知识片段为上下文,用生成式模型(如 seq2seq)产生最终的答案文本。生成阶段可以很好地整合和总结知识,生成连贯自然的答案。
RAG 的工作原理

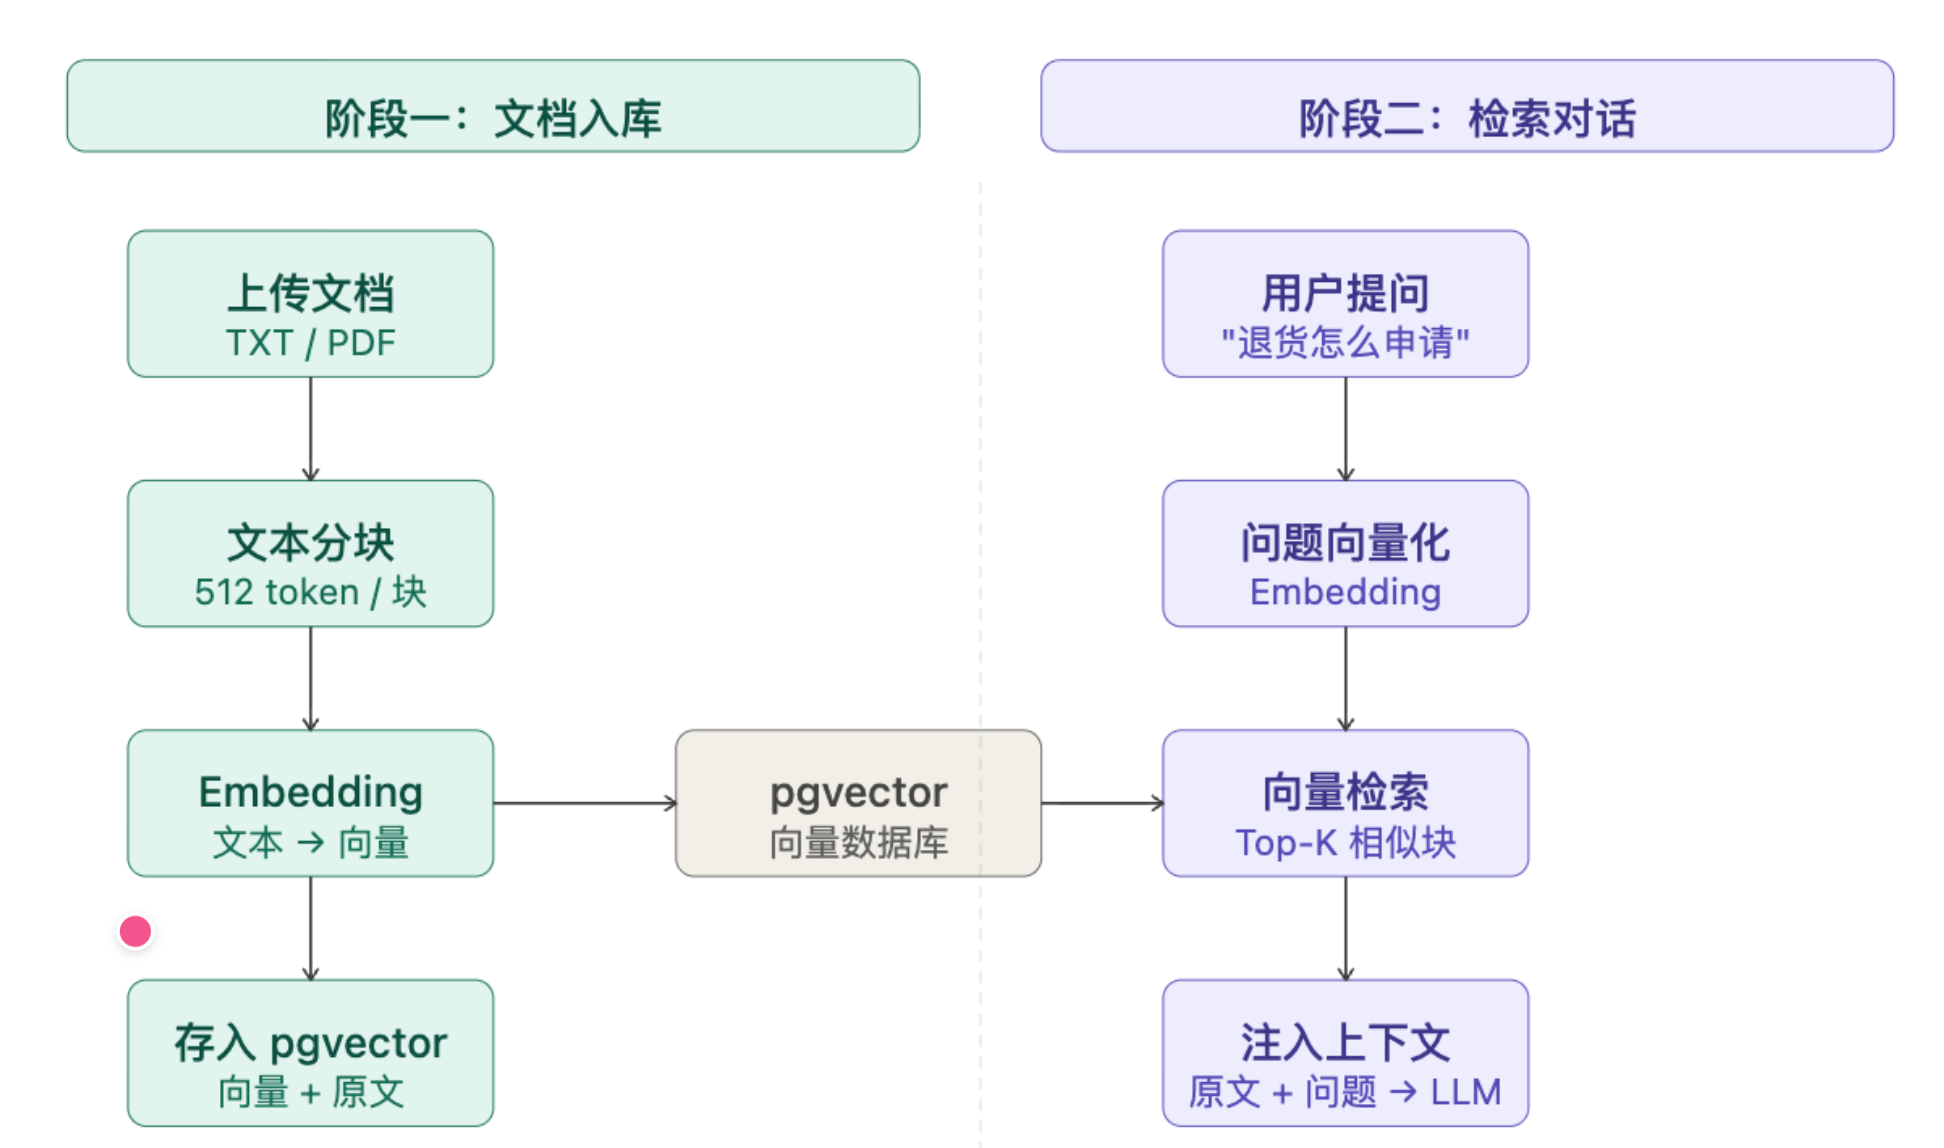
RAG 的工作原理可以概括为几个步骤。
- 检索:对于给定的输入(问题),模型首先使用检索系统从大型文档集合中查找相关的文档或段落。这个检索系统通常基于密集向量搜索,例如 ChromaDB、Faiss 这样的向量数据库。
- 上下文编码:找到相关的文档或段落后,模型将它们与原始输入(问题)一起编码。
- 生成:使用编码的上下文信息,模型生成输出(答案)。
阶段一: 数据准备阶段
文档解析器,把各种格式的文件转成纯文本。TXT 直接读,PDF 有文字版和扫描版两种,Word 用 Apache POI 解析
文本分块器,把长文档切成适合检索的小块。这是 RAG 里最影响效果的环节。块太大,Embedding 语义被稀释,检索不准,塞进 Prompt 还占 token 多;块太小,上下文丢失,答案不完整。常见策略有固定大小切分、按段落切分、递归分割(先按段落,太长再按句子)。
LangChain 提供的各种文本拆分器可以帮助你从下面几个角度设定你的分割策略和参数:
- 文本如何分割
- 块的大小
- 块之间重叠文本的长度
- Embedding 模型,把文本转成向量。一串浮点数,语义相近的文本向量在空间里也相近。
- 向量数据库,存向量,支持相似度检索,找和查询向量距离最近的几条
阶段二: 应用阶段
Retriever(检索器): 用户提问时把问题也转成向量,在向量数据库里找 Top-K 最相关的块。
Prompt 组装器,把检索到的原文块拼进上下文,告诉 LLM 基于以下资料回答。
Word2Vec
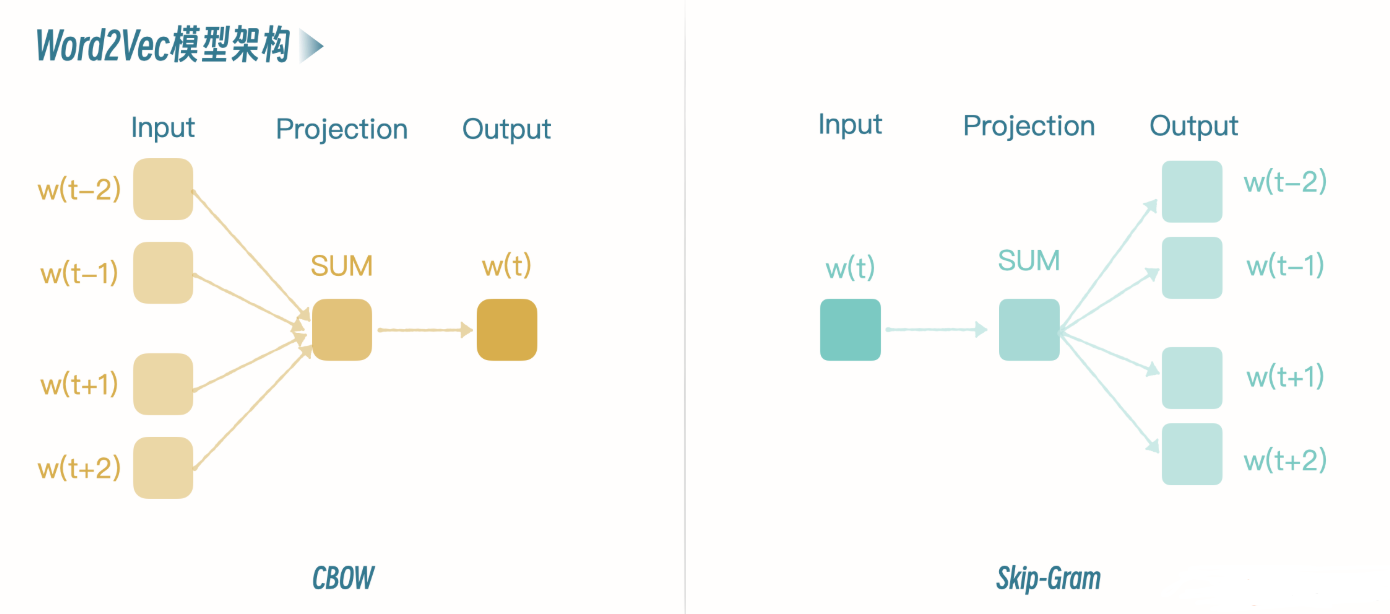
Word2Vec 模型基于两种主要架构:连续词袋(Continuous Bag of Words, CBOW)和跳字模型(Skip-Gram)。
优点
- 词嵌入质量高:Word2Vec 能够学习到富含语义信息的高质量词向量,使语义上相近的词在向量空间中也相近。
- 捕捉多种语言规律:Word2Vec 能够捕捉到一定的语法和语义规律,比如词类比:男人之于女人如同国王之于王后。
- 效率高:相比于早期的基于矩阵分解的词嵌入方法,Word2Vec 的训练效率更高,尤其是在处理大规模语料库时。
- 可解释性:Word2Vec 模型学习到的词向量具有一定的可解释性,可以通过向量运算进行词之间的关系探索
缺点
- OOV 问题:Word2Vec 模型只能对其训练期间见过的词汇生成向量。对于新出现的或者罕见的词汇,模型无法直接提供词向量(尽管可以通过一些技巧进行处理)。
- 词义多样性:Word2Vec 为每个词汇生成一个唯一的向量,因此无法直接处理一个词多种含义的情况,也就是多义词问题。
- 依赖于大量文本数据:为了训练出高质量的词向量,Word2Vec 需要大量的文本数据。在数据量较小的情况下,模型的效果可能会受限。
- 上下文独立:Word2Vec 生成的词向量是静态的,不考虑词在特定句子中的上下文。这与后来的上下文相关的词嵌入模型,如 ELMo、BERT 等形成对比。
- 缺乏层次化表示:Word2Vec 提供的是词汇级别的向量表示,缺乏更细致的语法和语义结构信息,这些在一些复杂的 NLP 任务中可能是必需的。
Seq2Seq(Sequence-to-Sequence)
从一个序列到另一个序列的转换。它不仅仅能理解单词之间的关系,而且还能把整个句子的意思打包,并解压成另一种形式的表达。
模型的核心由两部分组成:编码器(Encoder)和解码器(Decoder)。
- 编码器的任务是读取并理解输入序列,然后把它转换为一个固定长度的上下文向量,也叫作状态向量。.
- 解码器的任务是接收编码器生成的上下文向量,并基于这个向量生成目标序列。解码过程是一步步进行的,每一步生成目标序列中的一个元素,比如一个词或字符,直到生成特殊的结束符号,表示输出序列的结束。
GraphRAG(Graph Retrieval-Augmented Generation)
GraphRAG 是一种基于图的检索增强方法,由微软开发并开源。它通过结合LLM和图机器学习的技术,从非结构化的文本中提取结构化的数据,构建知识图谱,以支持问答、摘要等多种应用场景
